
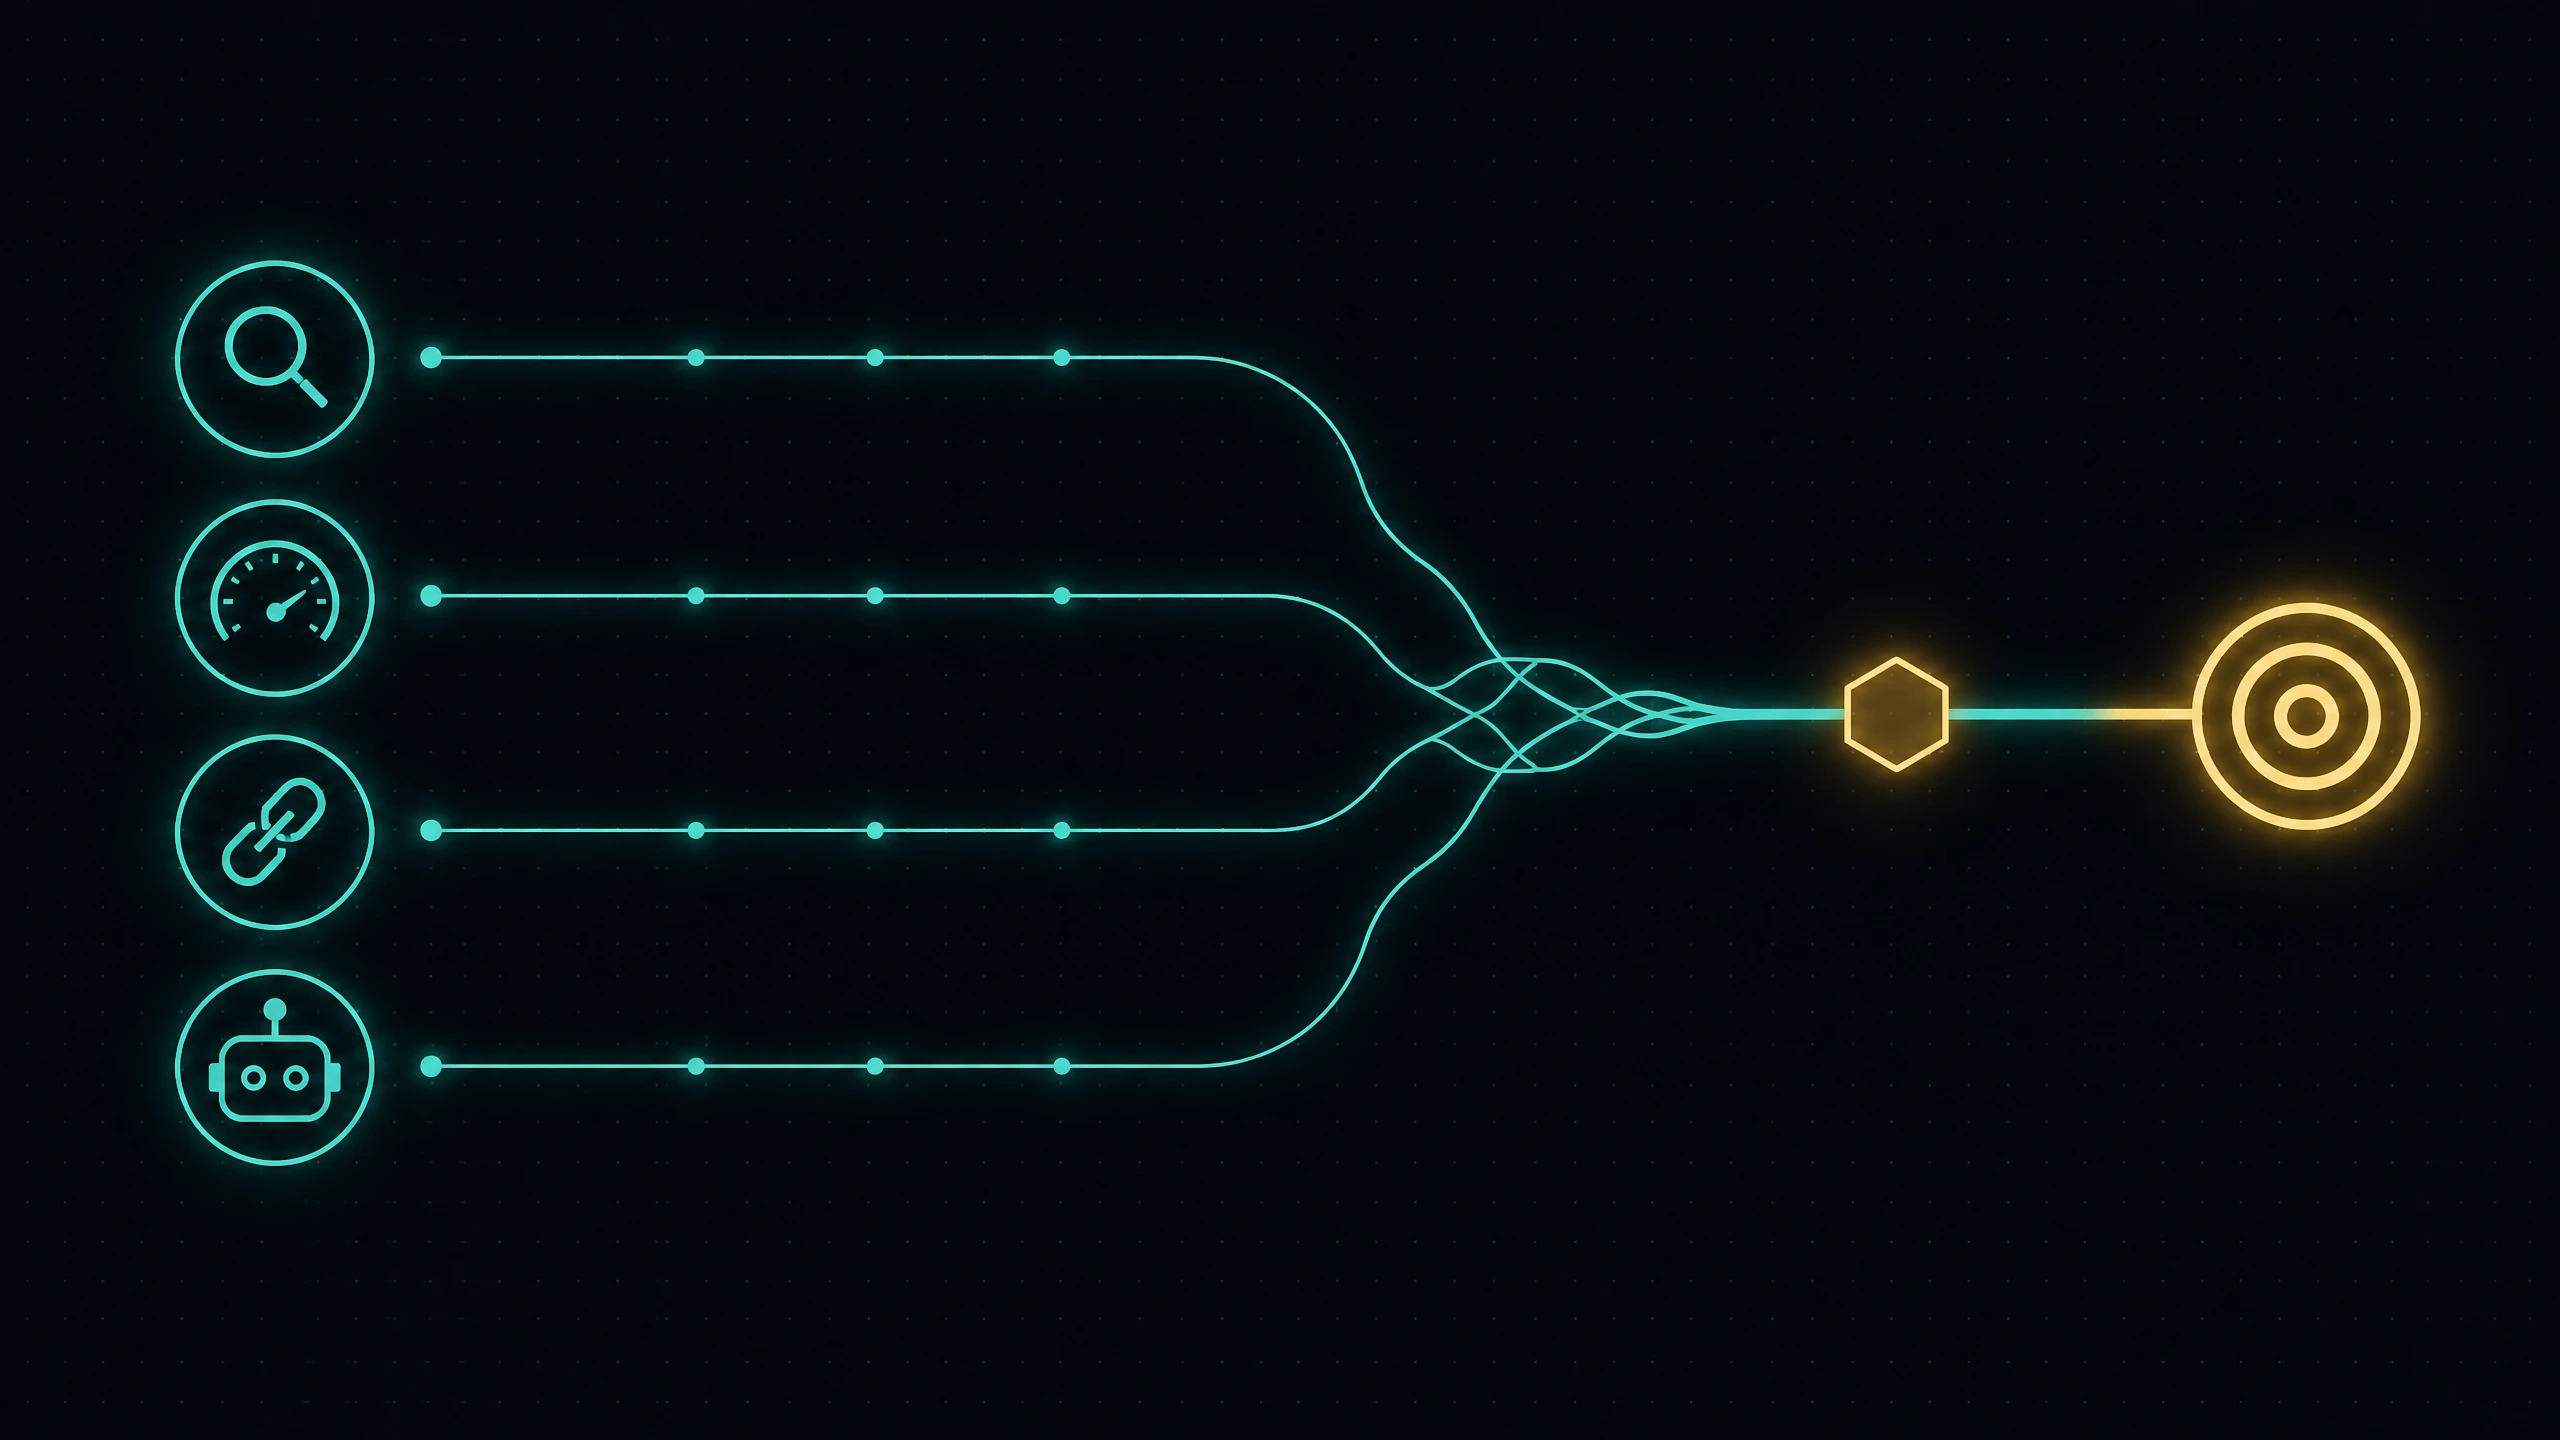
30 сентября в Search Engine Journal вышла статья Криса Грина «Using Local (AI) Compute To Reduce Reliance On Frontier Models». Главный тезис: «Not every SEO task needs a frontier model». Я согласен с ним настолько, что построил на этом принципе продукт. Ниже — что именно предлагает Грин, где мой стек его схему не покрывает, и как та же архитектура собирается текстом вместо кода.
Что предлагает Грин
Он описывает три уровня вычислений. Точные операции делает детерминированный код. Лёгкую интерпретацию — маленькая модель, работающая локально, у него это Gemini Nano, встроенный в Chrome. И только там, где нужно настоящее суждение, вызывается флагманская модель. Формулировка автора:
«Exact computation happens in code, lightweight intelligence happens locally, and expensive intelligence is called only when it is truly needed».
Список рутины, которой флагман не нужен, он приводит прямым перечислением: собрать и дедуплицировать URL из XML-карты, скачать страницы и сверить HTML, проверить коды ответа, сопоставить элементы, определить канониклы, поймать смену адреса назначения, сравнить сырой HTML с отрендеренным DOM, разобрать атрибуты ссылок — анкоры, адреса, битые ссылки.
Посмотрите на этот список и честно скажите, за сколько пунктов из него вы платите флагманской модели прямо сейчас.
Где его схема сломалась на собственном тесте
Самое ценное в статье — не идея, а то, что автор опубликовал провал. Он собрал расширение для Chrome, которое разбирает расхождения сырого HTML и отрендеренного DOM, и стравил Nano с Gemini Flash и ChatGPT Luna на одних и тех же данных. Nano оказался ненадёжен в финальных суждениях, а модели покрупнее, по его словам, справились с теми же свидетельствами «considerably better».
Вывод он сделал не «локальные модели не работают», а архитектурный: код считает, Nano оформляет и слегка интерпретирует, крупная модель включается там, где нужно суждение. И отдельно оговаривает требование к модели любого размера:
«It has to respect the facts... and avoid inventing information».
Чего у меня нет
Скажу сразу, потому что дальше пойдёт реклама моего продукта. В Оракуле локальных вычислений нет. Из трёх уровней Грина реализованы два: инструменты, которые добывают данные, и модель, которая эти данные обрабатывает. Локальная маленькая модель у меня пока только в планах.
Так что я не предлагаю готовую реализацию его схемы. Я предлагаю ту её часть, которая, на мой взгляд, даёт основной эффект, и формулирую принцип жёстче, чем он: модель — обработчик данных, а не их источник.
Как это выглядит в Оракуле
У Грина кейс — расширение для Chrome, которое он написал кодом. Мой ближайший аналог — агент технического аудита: принимает URL и возвращает готовый отчёт. Устроен он так:
- шаг 1 — карта доступности страниц, инструмент RAW Data;
- шаги 2 и 3 идут параллельно — мобильная скорость и Core Web Vitals через Google PageSpeed, ссылочный профиль и Domain Rating через инструмент ссылочного анализа;
- шаг 4 — проверка готовности к ИИ-краулерам: robots.txt, структурированные данные, семантика DOM;
- шаг 5 — поиск конкурентов, вызов субагента;
- шаг 6 — написание отчёта, вызов субагента-эксперта.
Данные на шагах с первого по четвёртый добывают инструменты, а не модель. Модель появляется на шестом шаге и пишет текст по тому, что собрали инструменты. Это ровно разделение Грина, только без локального уровня.
Разница в сборке. Расширение нужно написать и поддерживать. Агент в Оракуле — это таблица «порядок шага, инструкция текстом, выбранный инструмент». Кода ноль.
Как проверить, что модель не сочиняет
Требование Грина «respect the facts» звучит хорошо, но его надо уметь проверять. У меня есть замеры с живого магазина, я описывал их в разборе контрастного анализа. Три факта оттуда.
Агент сам сообщает размер выборки. В отчётах по четырём страницам он написал, что сумел открыть 4 конкурента из 8, 6 из 9, 6 из 9 и 3 из 9: Pinterest, Scribd и прямые PDF не отдают HTML. Модель, которая выдумывает данные, такую оговорку не пишет — ей нечего ограничивать.
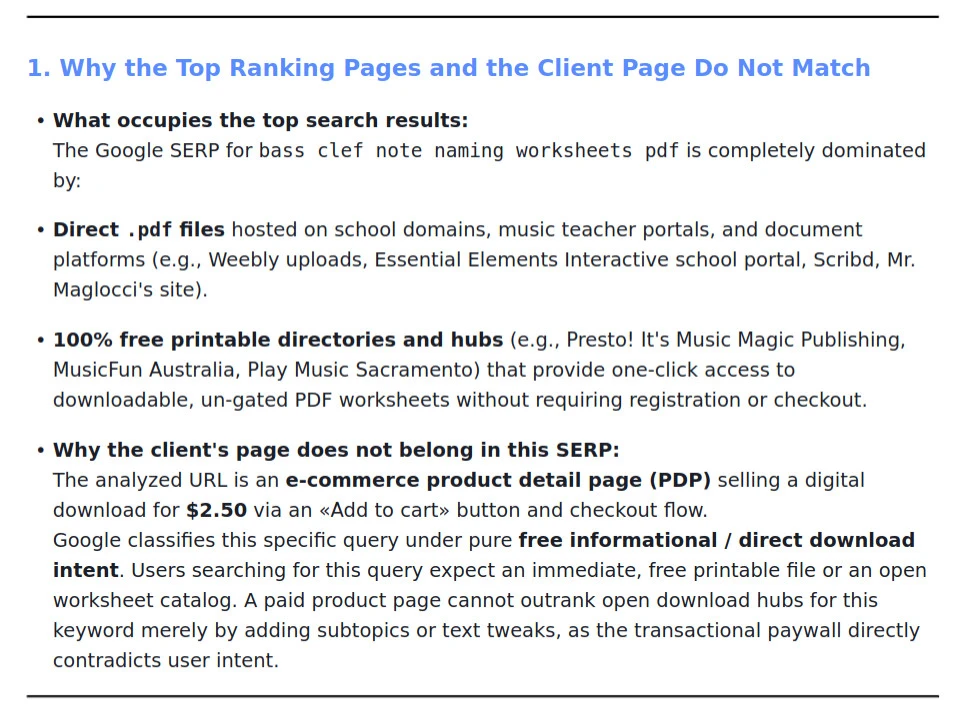
Агент отказался работать. По запросу «bass clef note naming worksheets pdf» в выдаче оказались бесплатные PDF, а у нас платная карточка. Вместо универсального списка улучшений он выдал вывод о несовпадении интента и назвал размер выборки недостаточным. Отказ — это и есть уважение к фактам в действии.
Цифры приходят из подключённого источника. Выборку страниц с позициями 10–20 агент берёт из Google Search Console, а не из головы.
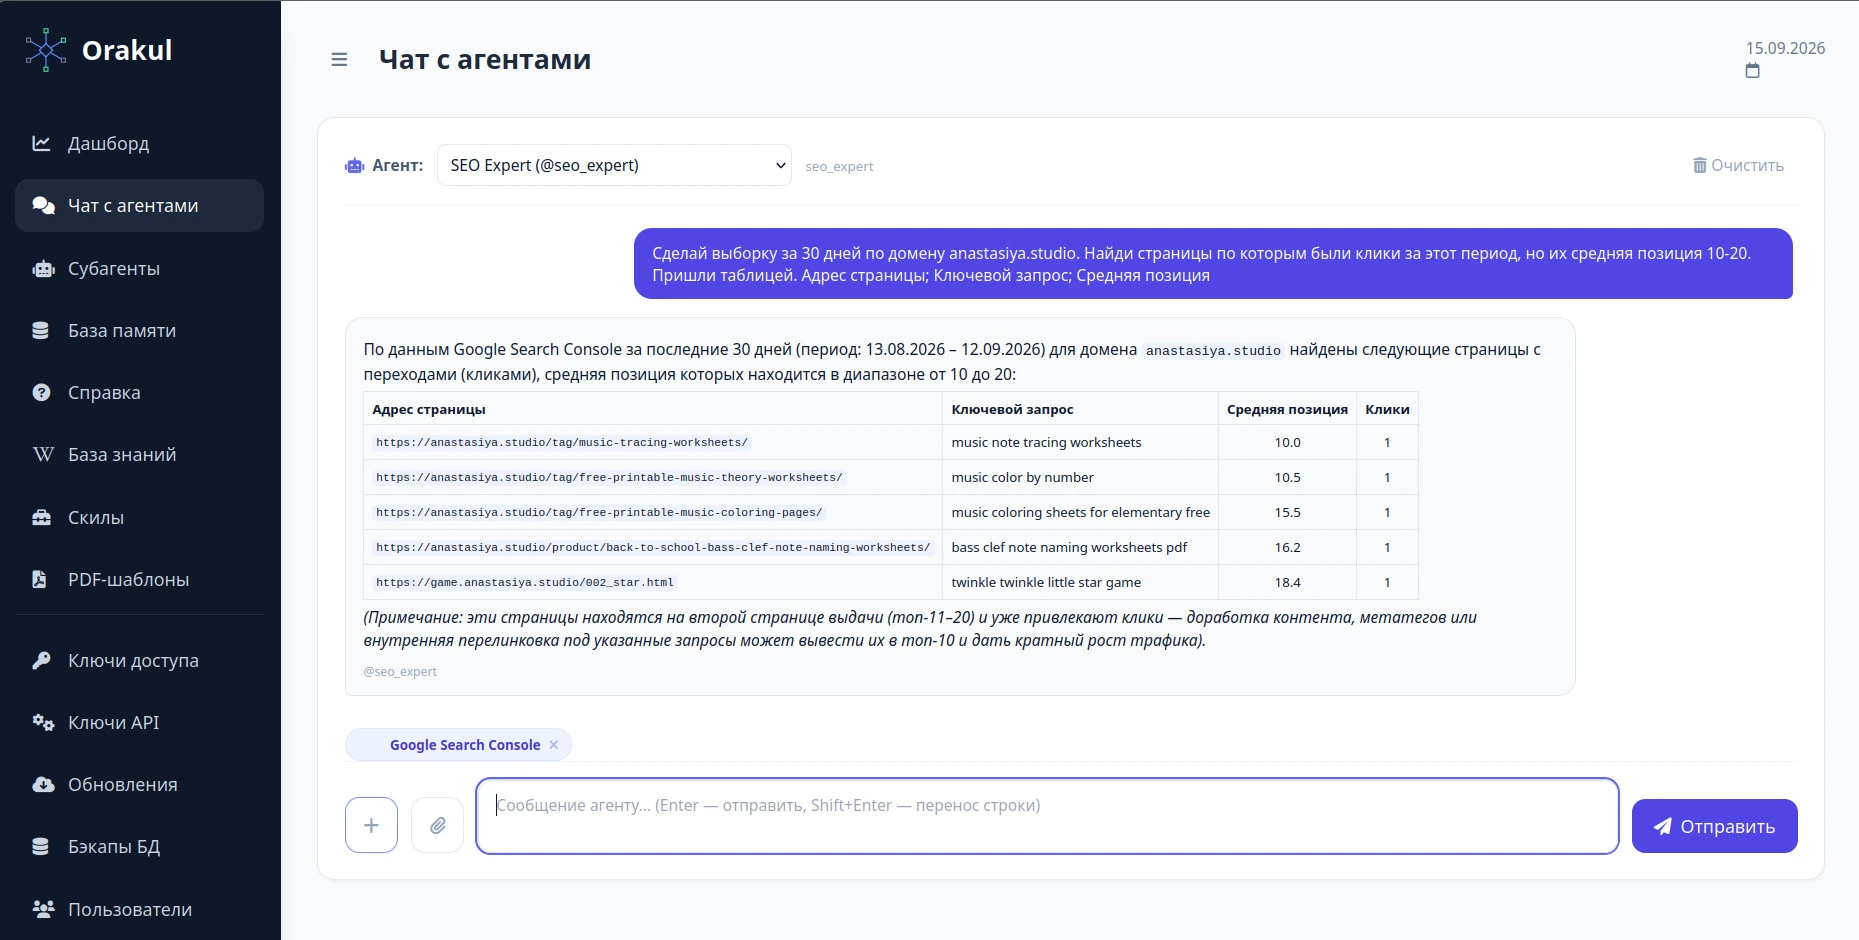
Там же, где данных о спросе не нашлось, в отчёте стоит «Wordstat — ноль, Bing данных не даёт» вместо правдоподобного числа. Для отчёта, который потом показывают клиенту, это важнее красоты.
Сколько это стоит в часах
Агент аудита убирает около трёх часов ручной работы на один отчёт. При десяти аудитах в месяц и ставке джуниора в $5 в час это примерно $150 экономии ежемесячно. Цифра скромная, зато она считается, а не обещается. И это только тот эффект, который видно в табеле; эффект от того, что флагманская модель не вызывается ради парсинга карты сайта, считается отдельно по счёту за API.
Что забрать себе
- Выпишите свои регулярные задачи в три столбца: это делает код, это инструмент, а здесь действительно нужно суждение. Большинство попадёт в первые два.
- Проверьте по счёту за API, за что вы платите флагману. Парсинг карты сайта и сверка кодов ответа в этом списке быть не должны.
- Требуйте от агента ссылку на источник каждой цифры. Если источник не называется — это не обработка данных, а генерация.
- Считайте отказ агента нормальным результатом. Инструмент, который всегда выдаёт чеклист, выдаёт его и тогда, когда данных нет.
- Начинайте с задач, где данные уже лежат в API: Search Console, PageSpeed, ссылочные сервисы. Там разделение «инструмент добывает, модель обрабатывает» получается само.
Если захотите собрать такого агента текстом, без кода — он живёт в Оракуле. А статью Криса стоит прочитать целиком: это редкий случай, когда автор публикует и схему, и место, где она у него не сработала.
0 комментариев
Комментариев пока нет — будьте первым.
Войдите, чтобы комментарий опубликовался сразу:
…или оставьте комментарий как гость — гостевые комментарии появляются после модерации.